Die Verarbeitung unterschiedlicher Datentypen und die Integration mit Analyseplattformen verläuft in SQL Server 2025 reibungsloser denn je. Zahlreiche Verbesserungen im Datenmanagement unterstützen KI- und moderne Anwendungs-Workloads.
Wichtige Verbesserungen bei der Datenverwaltung in SQL Server 2025
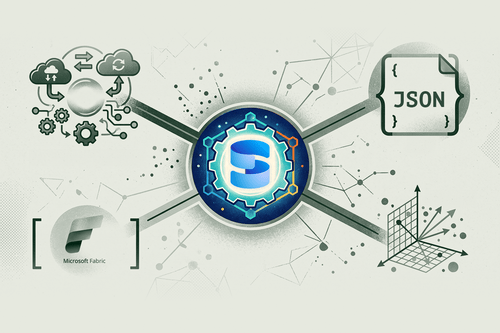
- Native JSON: Speichern und Abfragen von semistrukturierten JSON-Daten mithilfe eines speziellen Datentyps.
- Native Vektoren: Speichern Sie Vektordaten direkt in SQL Server für KI- und Machine-Learning-Workloads.
- Regex in T-SQL: Musterabgleich und Textverarbeitung ohne Rückgriff auf externe Tools.
- Fabric-Spiegelung: Spiegelung operativer SQL Server-Daten in Microsoft Fabric für Analysen nahezu in Echtzeit ohne herkömmliche ETL-Pipelines.
Nativer JSON-Datentyp und Indizierung
SQL Server 2022 konnte zwar JSON speichern, jedoch nur als einfachen Text (NVARCHAR), und es mithilfe von Funktionen abfragen. Im Jahr 2025 erhält JSON einen eigenen Datentyp (und wahrscheinlich eine spezielle Indizierung). Das bedeutet, dass JSON (semistrukturierte Daten) effizienter gespeichert und schneller abgefragt werden können. Entwickler können Daten in einem flexiblen JSON-Format modellieren, ohne dabei Leistungseinbußen hinnehmen zu müssen. Dies ist ideal für KI-Szenarien, in denen Eingabe- oder Ausgabedaten naturgemäß im JSON-Format vorliegen (z. B. das Ergebnis eines Modells oder eine Prompt-Konfiguration).
Nativer Vektordatentyp
Wir haben dies bereits im Zusammenhang mit KI erwähnt, doch als Funktion für das Datenmanagement ist die Einführung eines nativen Vektortyps an sich schon bemerkenswert. Dabei werden hochdimensionale Arrays als Spaltentyp behandelt, mit allen damit verbundenen Leistungsoptimierungen. Dies erspart Entwicklern die Notwendigkeit, Vektoren als BLOBs oder in separaten Tabellen zu speichern. Sie können Vektoren problemlos berechnen, speichern und indizieren, wodurch Ihre Datenbank von Grund auf zu einem Vektorspeicher für Machine-Learning-Anwendungen wird.
Unterstützung für reguläre Ausdrücke (Regex) in T-SQL
Die Textverarbeitung in SQL wird durch neue Regex-Funktionen (wie REGEXP_LIKE, REGEXP_REPLACE usw.) erheblich verbessert. Datenwissenschaftler und Entwickler müssen häufig Text anhand von Mustern filtern oder extrahieren (beispielsweise zur Validierung von E-Mail-Adressen oder zum Extrahieren von Hashtags aus einer Protokollmeldung). Bisher waren hierfür umständliche T-SQL-Workarounds oder eine CLR-Integration erforderlich. Jetzt ist diese Funktion fest integriert. Die Unterstützung von regulären Ausdrücken verbessert die Datenbereinigung und -aufbereitung direkt in der Datenbank – ein wesentlicher Schritt in vielen KI-Pipelines (wie beispielsweise die Vorverarbeitung von Text vor der Analyse).
Fabric Zero-ETL-Spiegelung (nahtlose Integration in Analysesysteme)
Microsoft Fabric ist eine einheitliche Analyseplattform (die Data Lake, Data Warehousing usw. umfasst). SQL Server 2025 kann Daten nahezu in Echtzeit und ohne ETL in das OneLake von Fabric spiegeln. Einfach ausgedrückt: Ihre operative Datenbank kann ihre Daten kontinuierlich in die Analyseumgebung replizieren, ohne dass komplexe ETL-Jobs (Extrahieren, Transformieren, Laden) erforderlich sind. Für das Datenmanagement bedeutet dies, dass die Trennung zwischen OLTP (Betriebsdaten) und OLAP (Analysedaten) verschwimmt; Sie verfügen automatisch an beiden Orten über aktuelle Daten. Wenn Sie Fabric nicht nutzen, können Sie mit einer ähnlich verbesserten Integration mit Azure Synapse oder anderen Analyseplattformen rechnen, doch Fabric ist das herausragende Feature.

Warum das wichtig ist: Diese Funktionen stellen sicher, dass moderne Daten – ob strukturiert, halbstrukturiert oder unstrukturiert – problemlos in SQL Server 2025 verarbeitet werden können. Die JSON-Unterstützung macht die Datenbank benutzerfreundlicher für Entwickler, die an Dokumentenspeicher oder die Arbeit mit APIs gewöhnt sind, die JSON zurückgeben. Sie können diese Daten nun ohne Impedanzfehlanpassung speichern und mit guter Leistung abfragen. Die native Vektorunterstützung bietet KI-Anwendungen eine direktere Möglichkeit, Vektordaten innerhalb von SQL Server zu speichern und zu verarbeiten. Die Regex-Unterstützung integriert gängige Aufgaben wie Musterabgleich und Textbereinigung in T-SQL, anstatt diese Arbeit an Skripte oder andere Tools auszulagern. Fabric-Spiegelung löst ein anderes Problem: die Übertragung von Betriebsdaten in die Analytik. Anstatt separate ETL-Pipelines aufzubauen und zu warten, können Teams SQL Server-Daten auf Fabric spiegeln und so aktuelle Daten für Berichts-, BI- und KI-Workloads verfügbar machen. Im Wesentlichen gilt: Wenn Ihr Unternehmen SQL Server für Transaktionsdaten nutzt und gleichzeitig umfangreiche Analysen oder KI-Anwendungen auf diesen Daten durchführen möchte, wird dies durch die Version 2025 erheblich vereinfacht. Sie müssen nicht mehr zwischen separaten Systemen oder nächtlichen Batch-Jobs hin- und herwechseln; die Daten fließen dorthin, wo und wann sie benötigt werden.
IoT-Anwendungsfall: Stellen Sie sich eine IoT-Umgebung vor, in der verschiedene Geräte Sensorwerte mit leicht unterschiedlichen Feldern senden. SQL Server 2025 kann diese Daten im JSON-Format speichern und es Entwicklern dennoch ermöglichen, Eigenschaften zu indizieren, die sie regelmäßig abfragen, wie beispielsweise Temperatur oder Luftfeuchtigkeit. Es besteht weniger Druck, die Ausgaben aller Geräte in dieselbe relationale Struktur zu zwängen, nur um die Suche nach den Daten zu vereinfachen. Für KI-Anwendungen könnten diese JSON-Dokumente dann direkt aus SQL in externe Modelle eingespeist werden. Beispielsweise könnten Sie einen JSON-Blob mit den Aktivitäten eines Kunden haben und ein KI-Modell aufrufen, um die Präferenzen des Kunden zu klassifizieren – und das alles innerhalb einer SQL-Abfrage. Der Vorteil der Regex-Funktion zeigt sich bei der Datenbereinigung: So könnte beispielsweise ein Cybersicherheitsteam im Rahmen einer Vorfallanalyse eine Regex auf Protokolleinträge in der Datenbank anwenden, um IP-Adressen oder Fehlercodes zu erkennen, ohne die Protokolle in ein Skript exportieren zu müssen.
Das Fabric-Spiegelungsszenario: Angenommen, ein Einzelhandelsunternehmen speichert seine Umsatz- und Bestandsdaten in SQL Server. Es möchte in der Cloud erweiterte Analysen durchführen (z. B. Power BI-Dashboards und maschinelles Lernen anhand historischer Trends). Mit SQL Server 2022 würde das Unternehmen Azure Synapse Link oder einen manuellen ETL-Prozess nutzen, um Daten regelmäßig in ein Data Warehouse zu kopieren. Fragt der CEO jedoch: „Wie sieht unsere Umsatzentwicklung gerade jetzt aus?“, könnte jede Verzögerung frustrierend sein. In SQL 2025 können neue Umsätze, sobald sie in der lokalen Datenbank erfasst werden, nahezu in Echtzeit in den Fabric-Lake gespiegelt werden. Ein Power BI-Bericht auf Fabric greift im Wesentlichen auf Live-Daten zu. Das Ergebnis sind reibungslose Analysen, bei denen sich Aktionen in der operativen Datenbank sofort in den Analysetools widerspiegeln. Dies ist auch im Bereich der KI von Vorteil: Man könnte komplexe Trainings- oder Prognosealgorithmen in Fabric auf Basis der aktuellen Daten ausführen und so kontinuierlich Vorhersagen erhalten, anstatt auf Batch-Updates zu warten. Die Datenbank-Engine unterstützt nun auch Szenarien wie den direkten Aufruf von REST-APIs über gespeicherte Prozeduren (sp_invoke_external_rest), was zusammen mit verwalteten Identitäten bedeutet, dass die Datenbank externe Daten direkt abrufen oder Daten nach außen senden kann – ein Aspekt des Datenmanagements, der über die Datenbank selbst hinausgeht.
Zusammenfassend lässt sich sagen, dass die Verbesserungen im Bereich der Datenverwaltung in SQL Server 2025 den Umgang mit den „3 Vs“ der Daten (Volumen, Vielfalt, Geschwindigkeit) innerhalb der Plattform erheblich vereinfachen: große Datenmengen, Vielfalt durch JSON und Geschwindigkeit durch Echtzeit-Spiegelung.
SQL Server wird mehr als nur eine Datenbank
Das Besondere an SQL Server 2025 ist nicht ein einzelner neuer Datentyp oder eine einzelne neue Funktion. Es geht vielmehr darum, wie viel mehr des Datenlebenszyklus nun direkt in SQL Server abgewickelt werden kann. JSON und Vektoren bieten Entwicklern mehr Flexibilität bei der Speicherung und Verarbeitung moderner Daten, reguläre Ausdrücke (Regex) ermöglichen eine umfassendere Datenaufbereitung direkt in T-SQL, und die Fabric-Spiegelung reduziert die Pipelines, die traditionell erforderlich waren, um Betriebsdaten in die Analyse zu übertragen.
Für Unternehmen, die bereits SQL Server einsetzen, bietet sich dadurch die Gelegenheit, die Möglichkeiten der Plattform neu zu überdenken. Daten, für die früher separate Speicher, eine individuelle Verarbeitung oder geplante ETL-Jobs erforderlich waren, können zunehmend über die gesamte Kette hinweg – von der Anwendung über die Analyse bis hin zur KI – miteinander verknüpft bleiben.
Das Ergebnis ist ein SQL Server, der besser für die Zukunft der Daten-Workloads gerüstet ist: vielfältigere Daten, schnellerer Zugriff darauf und ein deutlich kürzerer Weg von den Betriebsdaten zur Analytik und KI
Entdecken Sie unsere SQL Server 2025-Produkte
 |
Details
|
Verwandte Artikel zu SQL Server
-
SQL Server Enterprise vs. Standard: Zahlen Sie zu viel?
Vergleichen Sie die Funktionen, Kapazitätsgrenzen und Lizenzkosten von SQL Server Standard und Enterprise und finden Sie heraus, wo SQL Server 2025 Ihnen Möglichkeiten bieten könnte, Ihre Edition optimal anzupassen.
-
Semantische Suche und Echtzeitanalysen in SQL Server 2025
Erfahren Sie, wie die vektorbasierte Ähnlichkeitssuche, die semantische Suche und Echtzeitanalysen die Art und Weise verändern, wie Unternehmen SQL Server-Daten durchsuchen, analysieren und darauf reagieren.
-
SQL Server 2025: Die wichtigsten Aspekte, die IT-Teams vor dem Upgrade berücksichtigen sollten
Informieren Sie sich über die Entscheidungen hinsichtlich Lizenzierung, Edition, Kapazität, KI, SSRS und Migration, die IT-Teams vor einem Upgrade auf SQL Server 2025 berücksichtigen sollten.
-
Maschinelles Lernen in die Datenbank integrieren: Die KI-Modellfunktionen von SQL Server 2025
Entdecken Sie externe KI-Modelle, Vektor-Einbettungen, die KI-Orchestrierung innerhalb der Datenbank und die Modellverwaltung in SQL Server 2025.
-
Die Zukunft der Datenbanken: KI-gestützte Funktionen in SQL Server 2025
Verschaffen Sie sich einen Überblick über die KI-Funktionen von SQL Server 2025, darunter Copilot-Tools, Vektordaten, semantische Suche, natives JSON und neue Sicherheitsfunktionen.
-
SQL Server 2025 – KI-Entwicklertools: Copilot, LangChain und mehr
Erfahren Sie, wie Copilot, LangChain, Semantic Kernel und andere KI-Tools Entwicklern dabei helfen können, Abfragen und KI-gestützte Datenbank-Workflows zu erstellen.
-
Intelligentere Abfragen: Wie SQL Server 2025 komplexe Befehle in natürliche Sprache übersetzt
Erfahren Sie, wie Abfragen in natürlicher Sprache, Embeddings, semantische Suche und RAG den Benutzern helfen, SQL Server-Daten auf neue Weise zu finden und damit zu arbeiten.
-
Bewährte Verfahren für die SQL Server-Sicherheit
Sehen Sie sich praktische Möglichkeiten zum Schutz von SQL Server-Daten an, darunter Verschlüsselung, Sicherheit auf Zeilen- und Spaltenebene, Protokollierung, Authentifizierung und Zugriffskontrollen.